发现 
该作品还没有经过官方审核。访问演示、下载或复制命令前,请自行确认来源可信。
详细介绍
项目简介
MLX-Serve 是一个面向 Apple Silicon 的原生本地模型推理服务,由一个 macOS 原生应用和一个本地服务器组成。服务器同时提供 OpenAI、Anthropic 与 Ollama 兼容接口,可离线运行,不需要 Python,也不需要账号,采用 MIT 许可。
它由 Zig 编写的后端与 Swift 编写的前端组成,可以运行对话、编码代理、图像、视频、音乐、语音与 3D 生成等多种开放模型。
主要功能
- 本地模型上的编码代理:
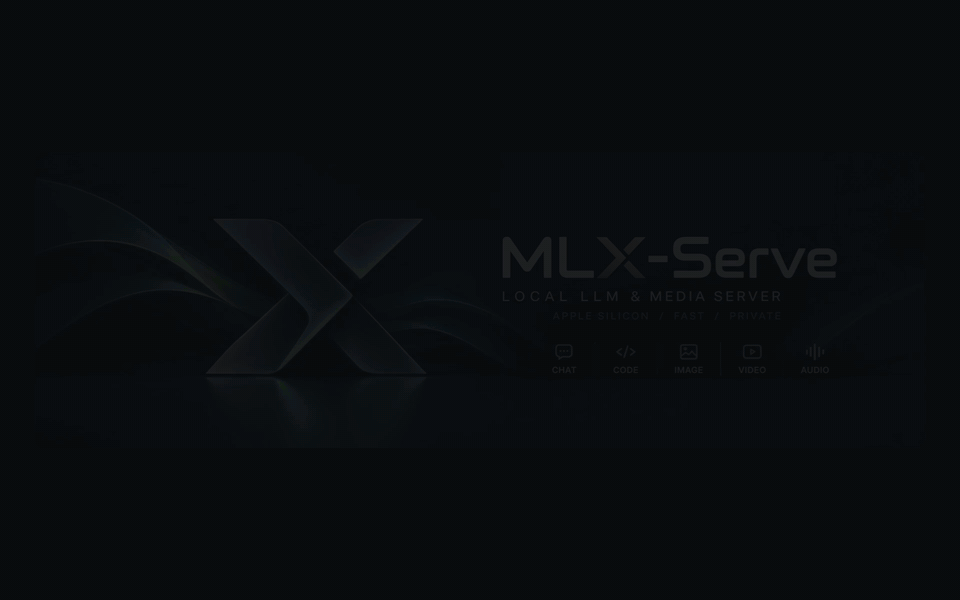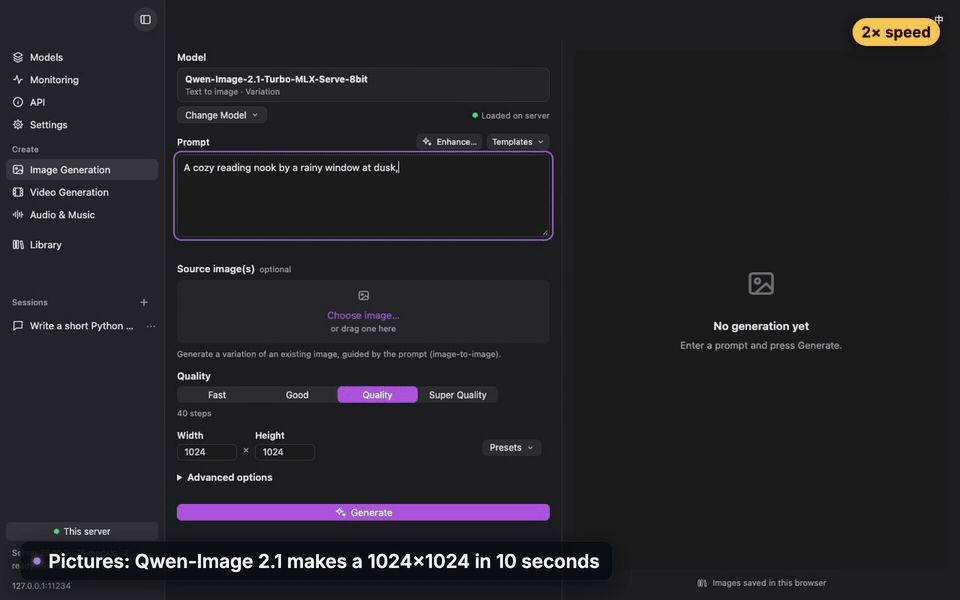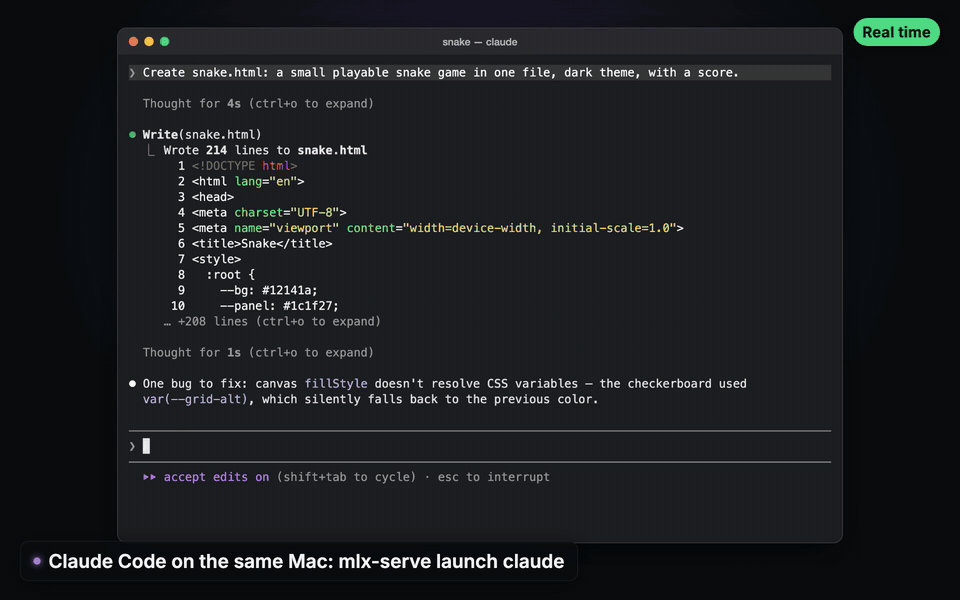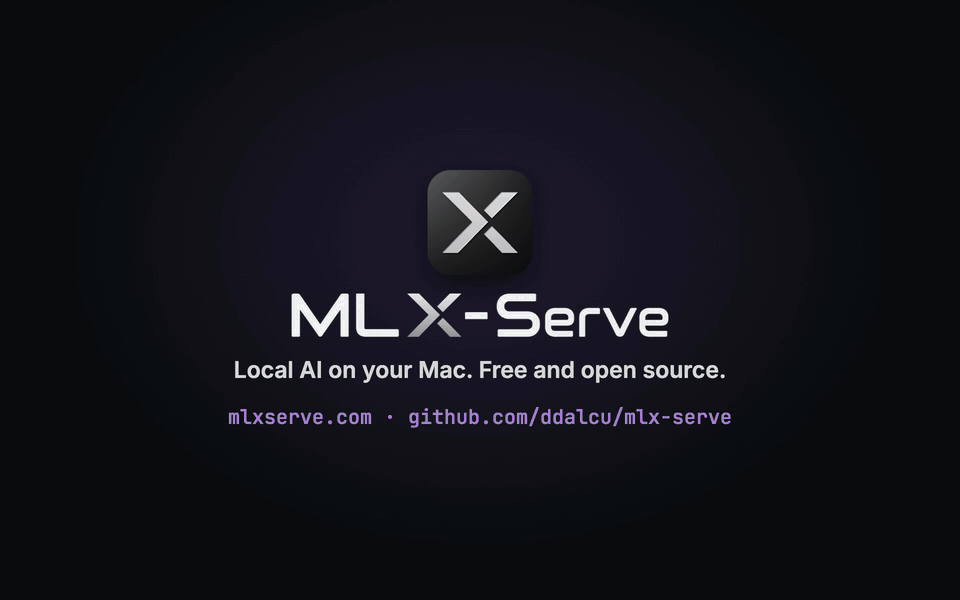
mlx-serve launch claude可让 Claude Code 连接本机模型,并按模型真实上下文窗口配置;Codex、OpenCode、pi、Grok 等也可同样接入。 - 图像、视频、音乐、语音与 3D:支持 FLUX.2、Qwen-Image、Krea、MOSS-Image、LTX-Video、MiniMax-H3、ACE-Step、YuE2、Qwen3-TTS(含声音克隆)与 Hunyuan3D,可在应用内或通过 HTTP 调用。
- 转录与会议纪要:支持 30 种语言的语音转文字,带词级时间戳与说话人区分;菜单栏可录制通话并生成纪要。
- 超出本机内存的模型:GLM-5.3-Flash、MiMo-V2.6-Flash、DeepSeek-V4.1-Flash 可在 128 GB Mac 上从 SSD 流式读取专家权重运行;两台通过 Thunderbolt 5 连接的 Mac 可协同运行同一个模型,局域网内的 Mac 之间也能共享模型。
- 常驻本机的助手:可与文档对话、免手操作语音交流,为代理提供沙箱 shell 与 MCP 工具,或用自然语言安排定时任务。
- 现成的 API:OpenAI chat、completions 与 Responses,Anthropic Messages 与 Ollama 接口共用同一端口,支持流式输出、工具调用、JSON schema、视觉与推理。
安装与使用
应用:下载 MLX-Serve.dmg,拖入 Applications 后打开。需要 Apple Silicon 与 macOS 26.2 或更高版本,应用会推荐适配本机内存的模型并自动更新。
Homebrew:
brew tap ddalcu/mlx-serve https://github.com/ddalcu/mlx-serve
brew install --cask mlx-serve
也可以只安装命令行服务器:brew install mlx-serve。
命令行:
mlx-serve run gemma4
mlx-serve pull gemma4:26b
mlx-serve serve
服务器默认监听 http://localhost:11234,可把任意 OpenAI、Anthropic 或 Ollama 客户端指向该地址,也可在浏览器打开使用内置 Web 控制台。
从源码构建:需要 Xcode 26.2 或更高版本与 Homebrew。
git clone --recurse-submodules https://github.com/ddalcu/mlx-serve && cd mlx-serve
./app/build.sh
注意事项
- macOS 应用需要 Apple Silicon 与 macOS 26.2 或更高版本。
- iPhone 版本需要 A17 Pro 级别及以上的机型与 iOS 26。
- 每个版本也提供面向 NVIDIA GPU 的 Linux 下载(RTX 20 至 50 系列为 x64,DGX Spark、GH200、Jetson Thor 为 arm64);Windows 搭配 NVIDIA 显卡需按文档脚本自行构建。
- 应用会根据机器内存推荐首个模型,例如 16 GB 推荐 Gemma 4 E4B,96 GB 及以上推荐 Qwen3.8-Flash-Next。
本作品整理自 GitHub 开源项目 ddalcu/mlx-serve,原作者 @ddalcu。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- v26.11.2当前版本
新增 --dist tensor,可让两台 Thunderbolt 5 Mac 协同运行 DeepSeek-V4.1-Flash,双 M3 Ultra 写入速度提升 57%;--mlx-gguf 让 DeepSeek-V4.1 等 GGUF 以 MLX 引擎高速运行并支持图像输入;提升多款模型的写入速度,模型在请求间常驻内存,长对话保持缓存。
评论