Magnitude:本地大模型推理引擎
一个自动针对你的硬件调优 kernel 的开源推理引擎,本地跑开源模型,比 Ollama 更快。
- 浏览
- 4
- 访问
- 0
- 下载
- 0
- 版本
- v@magnitudedev/[email protected]
- 平台
- Windows、macOS、Linux
详细介绍
项目简介
Magnitude 是一个开源的本地大模型推理引擎,用 Rust 编写,采用 Apache-2.0 协议。它会在你的实际硬件上自动调优 kernel,为每个模型找到最快的运行方式,官方称平均比 Ollama 快 2 倍以上。
它支持 Apple Silicon、NVIDIA、AMD、Intel GPU,也可以只用 CPU 运行。产品形态包括桌面应用和 CLI,可以一键接入你已经在用的 agent(Pi、OpenCode、Hermes、Codex 等)。
主要功能
- 按硬件调优 kernel:下载模型时,它会在你的芯片上花最多约一分钟尝试不同的数学切分方式(多少 GPU 线程协作、每块数据多大、预取多远),保留不改变模型输出且最快的一组组合。
- 内置最佳 drafter:每个模型都附带最快的投机解码 drafter。
- 弹性内存:量化 KV 可让每个 agent 的内存减半,agent 停止后即释放。
- 并发会话:多个会话共享 prefix cache,避免彼此拖慢。
- 兼容你的 agent:一键连接 Pi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi、Cline;其他工具可通过 OpenAI 兼容 API 接入。
- 本地与隐私:提示词、文件、模型都留在本机,模型下载完成后无需联网,也没有 token 费用。
安装与使用
macOS / Linux 终端安装:
curl -fsSL https://magnitude.dev/install.sh | sh
Windows PowerShell:
irm https://magnitude.dev/install.ps1 | iex
也可以直接下载安装包:
- macOS:Apple silicon · Intel
- Windows:x64
- Linux x64:.deb · .rpm · .pkg.tar.zst
- Linux ARM64:.deb · .rpm
在服务器上运行:在 Linux 和 macOS 上,magnitude server setup 会把 Magnitude 安装成随开机启动的服务,退出登录后继续运行、自动更新,并对外提供浏览器和 agent 的访问。详见 Remote server。
支持的模型列表见 magnitude.dev/models。
注意事项
- 没有固定的最低硬件要求:配置小的机器跑小模型,内存越多能跑的模型越大。
- 支持 macOS、Linux、Windows 三个平台。
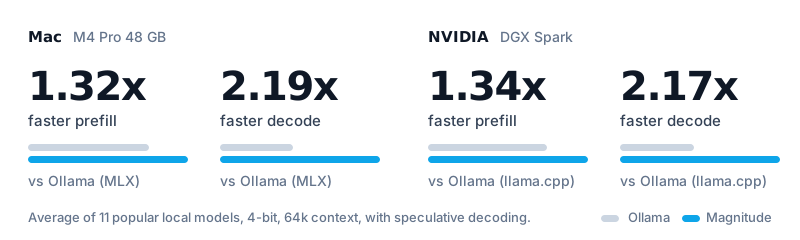
- 官方基准测试称,在 Mac 与 NVIDIA 上对 11 个热门本地模型取平均,Magnitude 的 prefill 约快 1.3 倍、decode 约 2.2 倍于 Ollama,完整数据见 magnitude.dev/benchmarks。
- 优化的 kernel 主要覆盖最流行的开源权重大模型家族,这也是它能胜过通用推理引擎的原因。
本作品整理自 GitHub 开源项目 magnitudedev/magnitude,原作者 @magnitudedev,许可证 Apache-2.0。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- v@magnitudedev/[email protected]当前版本
Anthropic 兼容的 messages 与 token 计数端点不再强制要求 2023-06-01 版本的 anthropic-version 头,任意值或不带该头都能接受;修复 Metal 上流式加载权重表时超出预留导入内存的问题,导入批次现在共享同一内存预算计划。
- v@magnitudedev/[email protected]
修复 Discover 页面与模型卡在启动后每隔几秒闪回评估状态的问题;模型目录新增 LFM3-1.7B 与 LFM3-VL-2B(Q4 QAT、Q6、Q8),其中 LFM3-VL-2B 支持图像输入。
- v@magnitudedev/[email protected]
新增侧边栏 Docs 链接;聊天只在你停留在底部时跟随新输出;模型重新评估时保留上次适配结果;Intel GPU 列为受支持硬件;Qwen3.8 Flash Next NVFP4 改为变体并更新 ID;各平台一键安装,进度更清晰、失败更少。
评论