详细介绍
项目简介
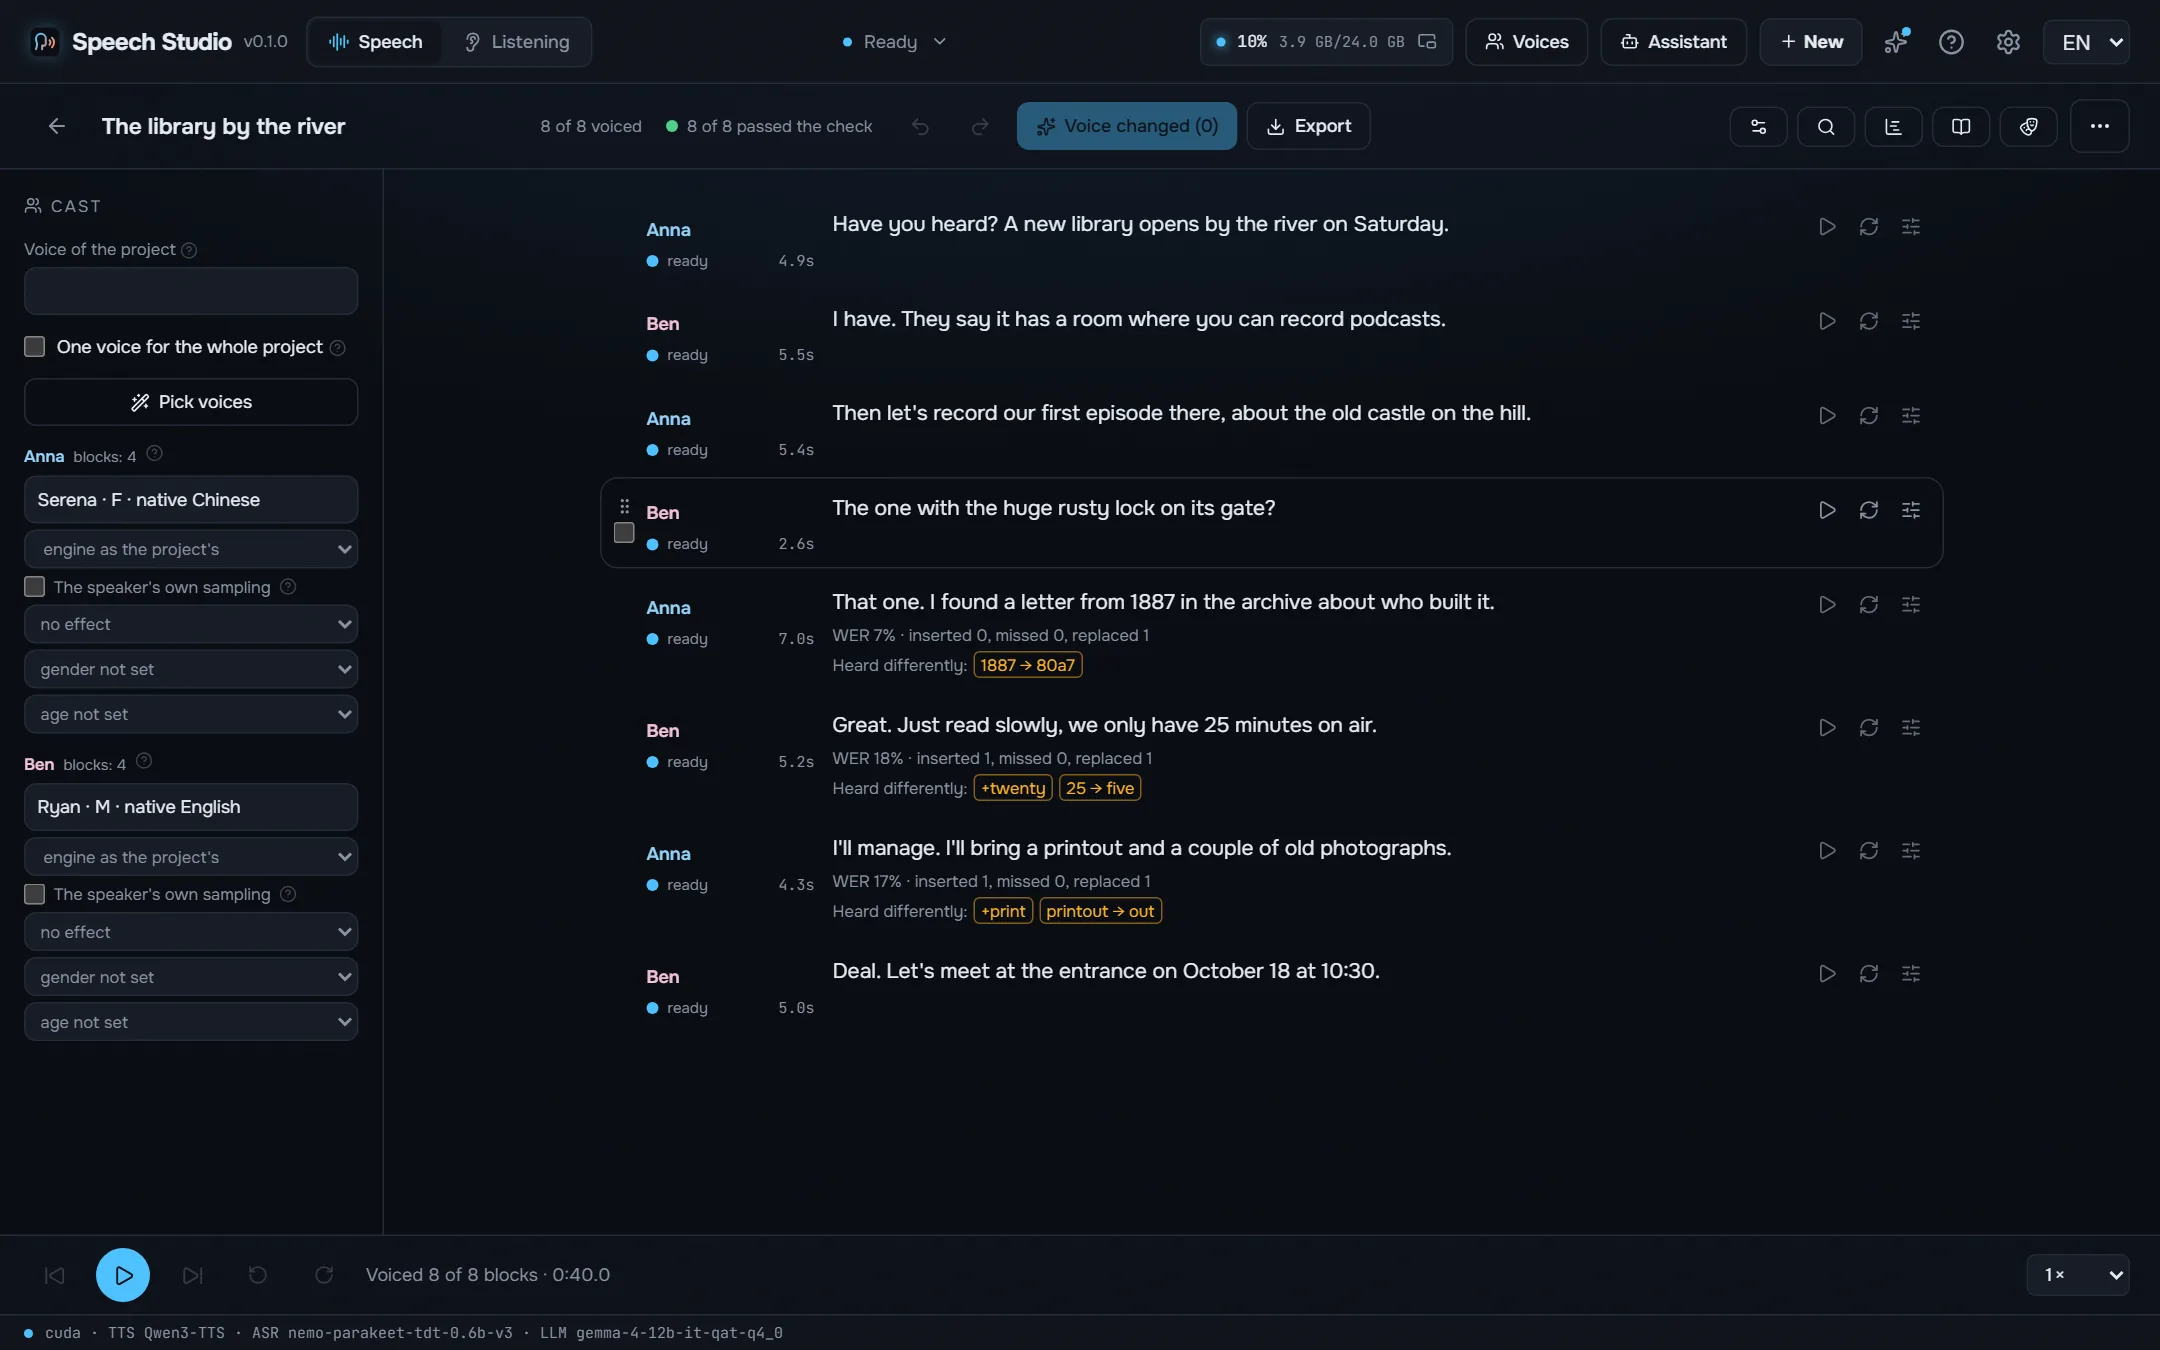
Speech Studio 是一款免费、离线的 AI 语音工作室,支持 Windows、macOS(Apple 芯片)与 Linux。它由 Rust 加原生 C++ 引擎(GGUF/ONNX,运行在 CUDA、Vulkan 或 Metal 上)构建,不内置 Python、torch 或 CUDA wheel,是一个原生应用。所有处理都在本机完成,文本、录音与声纹不会离开电脑。
俄语处理是它的重点:数字按正确的格与性朗读,还有日期、时间、金额、单位、罗马数字、拉丁品牌名与缩写,以及重音、「ё」和同形异读的判别。
软件有三种模式:
| 模式 | 作用 |
|---|---|
| 🔊 Speech | 单行文本、按角色分配声音的对话、导演生成的播客,或整本 EPUB/FB2/PDF/DOCX 书 → 生成语音块,导出 WAV、FLAC、MP3、OGG、M4A 或带章节的 M4B |
| 👂 Listening | 音频、视频或链接 → 带说话人和词级时间戳的转写,卡拉 OK 播放器、按文字切分、导出 SRT/VTT/ASS/TXT/JSON、与参考文本比对 |
| 🎙️ Live | 与通过 MCP 接入的 AI 代理语音对话,代理边写边说,你对着麦克风回答并逐句识别 |
主要功能
声音与引擎
- 五个本地引擎:Higgs Audio v3(克隆、情绪与声音效果)、Fish Audio Drama 3、Supertonic 3(十个内置声音)、Qwen3-TTS 1.7B(九个内置声音、克隆、按块给出指令)以及带俄语重音的 Qwen3-TTS(运行期加载 LoRA)。
- 声音库:一键声音包、云端目录中的俄语声音、麦克风录制、文件与 ZIP 导入,带照片、性别、年龄、语言、标签与授权信息;参考文本转写一次后保留。
- 参考音清理:Mel-Band Roformer 从音乐中分离人声,DPDFNet 按强度去噪,原始文件保留。
- 按描述生成声音:Qwen3-TTS VoiceDesign 依据一句描述生成声音,试听多个候选后存入声音库。
让文本读得对
- 俄语规范化器:数字、日期、时间、金额、单位、罗马数字、拉丁品牌名与缩写。
- 由 RUAccent 处理重音、「ё」与同形异读,存疑处高亮提示,你自己写的
+标记会保留。 - 发音词典:替换、正则与音素,可按项目、语言、声音或引擎限定范围,支持导入 Balabolka 的
.rex/.dic/.bxd。 - SpeechKit 兼容标记:
+重音、sil<[300]>与[pause 500ms]停顿、[rate:1.2]语速、**accent**;引擎不支持的部分会被标出,而不是静默丢弃。
项目与产出
- 以文本为时间线:带说话人的块、每个块最多五条 take、失效追踪、撤销重做、拖拽排序、正则搜索替换、备注与标记。
- 质量控制:每条 take 重新识别后逐词比对,并检查削波、静音、截断、结尾爆音、重复语句、长尾、噪声或音乐、与参考声音的相似度。
- 有声书:EPUB、FB2、PDF、DOCX、HTML、Markdown、TXT,章节预览、导演分配角色、带章节与封面的 M4B、ACX 响度检查。
- 字幕配音:SRT、VTT、ASS 按时间轴配音,必要时提前提速、重试、拉伸并借用前一句的静音。
- 导出检查与响度预设:视频(−14 LUFS)、播客(−16 LUFS)与 ACX,配有真峰值限制器。
- 后期:文本下方的轨道编辑器,可移动、裁剪、淡入淡出与调电平,加入音乐与音效。
- 项目文件
.speechproj携带文本、声音与音频,可迁移到另一台电脑。
听写
- Parakeet-TDT v3、Nemotron 3.5(28 种语言带标点)、CrisperWhisper 2.0 turbo(99 种语言带词级时间戳),Nemotron 3 Diarization 最多区分八个说话人,Silero VAD v6 在停顿处切分长录音。
- 批量拖入多个文件排队识别;可铺设已知文本与录音对齐;可从每个说话人最干净的字句生成声音库声音。
安装与使用
从 latest release 下载安装并启动。模型、引擎、CUDA 与 VC++ 运行时以及 ffmpeg 由应用在首次运行时自动下载;如果作者的其他工作室已有同一模型,会直接复用。
应用打开期间会在 http://127.0.0.1:8797/mcp 提供 MCP 服务,代理(如 Claude Code、Claude Desktop、Cursor、Codex)可以通过同一套代码完成窗口里能做的事:一句话把文本合成到文件、逐块创建与编辑项目、为角色分配声音、按描述设计声音、转写与校验录音、导出带章节和字幕的有声书。设置中的 Agent (MCP) 会显示是否已连接以及需要粘贴到客户端的配置。
claude mcp add --transport http speech-studio http://127.0.0.1:8797/mcp
其他客户端:
{ "mcpServers": { "speech-studio": { "type": "streamable-http", "url": "http://127.0.0.1:8797/mcp" } } }
连接后先读取服务器提供的资源 studio://skill(与 docs/mcp-skill.md 内容相同),再用工具 studio_status 开始。
同一端口还提供 OpenAI 音频 API 兼容接口——POST /v1/audio/speech、POST /v1/audio/transcriptions、GET /v1/models——用声音库中声音的名称作为 voice 即可。
注意事项
- 应用以 NVIDIA GPU 为构建和测试基准,其他硬件后端请参考 README 中的 What runs where 一节。
- 云端声音(OpenRouter、Google Gemini、fal.ai、Runware)默认关闭,各自使用独立的 key,首次调用前需要确认。
- 代理唯一做不到的事情是打开麦克风:Live、录音和麦克风测试只能由你亲自点击或按键启动;Live 中可用 M 或 Ctrl+Shift+Space 暂停。
- 只有本机上的程序可以连接该 MCP 服务与 API。
本作品整理自 GitHub 开源项目 timoncool/speech-studio,原作者 @timoncool。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- v0.3.5当前版本
界面可整体缩放 90%–150% 并记住设置;云端声音目录支持按性别、年龄、语言、最短时长筛选,搜索名称与描述、试听样本后下载,目录共 1,636 个声音;声音库也支持同样的搜索与筛选。
评论