详细介绍
项目简介
DeepCamera 是 SharpAI 开源的 AI 摄像头技能平台。它的开源技能为摄像头加上 AI 能力:VLM 场景分析、目标检测、行人重识别,全部用 Qwen、DeepSeek、SmolVLM、LLaVA 等模型在本地运行。项目在既有的面部识别、RE-ID、跌倒检测和 CCTV/NVR 监控能力之上,用现代 AI 扩展了技能目录;所有推理都在本地完成,以最大化隐私保护。
配套的桌面应用 SharpAI Aegis 是 DeepCamera 的桌面伙伴:用 LLM 自动完成环境搭建、摄像头技能配置和整条 AI 流水线管理,无需手动操作 Docker 或 CLI;它还增加了智能体层,包括持久记忆、与摄像头对话的 agentic chat、AI 视频生成、语音(TTS),以及通过 Discord / Telegram / Slack 的对话式消息。
主要功能
技能化架构
每个技能都是自带模型、参数和通信协议的独立模块,采用标准化的 SKILL.md 清单 + requirements.txt 依赖模型,通过 JSONL(stdin/stdout)协议与 Aegis 通信。检测类技能在 Aegis 看来完全可互换:Aegis 把一帧写入共享卷、在 stdin 发出 frame 事件,再从 stdout 读取 detections。所有技能都登记在 skills.json 中,便于程序化发现。
技能目录(部分)
| 类别 | 技能 | 作用 | 状态 |
|---|---|---|---|
| 检测 | yolo-detection-2026 |
实时 80+ 类检测,经 TensorRT / CoreML / OpenVINO / ONNX 自动加速 | ✅ |
| 检测 | yolo-detection-2026-coral-tpu |
Google Coral Edge TPU,USB 加速器上约 4ms 推理 | ✅ |
| 检测 | yolo-detection-2026-openvino |
Intel NCS2 USB / Intel GPU / CPU 多设备 | 🧪 |
| 检测 | face-detection-recognition |
人脸检测与识别 | 📐 |
| 检测 | license-plate-recognition |
车牌检测与识别 | 📐 |
| 分析 | home-security-benchmark |
LLM & VLM 安防性能评测套件 | ✅ |
| 隐私 | depth-estimation |
实时深度图隐私变换,在保留活动信息的前提下匿名化画面 | ✅ |
| 分割 | sam2-segmentation |
Segment Anything 2 点击分割,支持点/框提示与视频跟踪 | ✅ |
| 标注 | dataset-annotation |
AI 辅助数据集标注,导出 COCO/YOLO/VOC | ✅ |
| 训练 | model-training |
Agent 驱动的 YOLO 微调:标注、训练、导出、部署 | 📐 |
| 自动化 | mqtt / webhook / ha-trigger |
事件驱动的自动化触发 | 📐 |
| 集成 | homeassistant-bridge |
Home Assistant 摄像头接入,检测结果输出 | 📐 |
✅ 就绪 · 🧪 测试中 · 📐 计划中
硬件自动适配
共享的 env_config.py 会自动探测 GPU 并把模型转换成最快的原生格式:NVIDIA → TensorRT,Apple Silicon → CoreML,Intel → OpenVINO IR,AMD / CPU → ONNX。Coral TPU 技能使用 ai-edge-litert(LiteRT)配合 libedgetpu delegate,支持 Linux、macOS、Windows 上的 Python 3.9–3.13。
LLM 辅助技能安装
技能由自主 LLM 部署代理安装,流程包括:读取 SKILL.md、requirements.txt、package.json 完成探测;检测 NVIDIA(CUDA)、AMD(ROCm)、Apple Silicon(MPS)、Intel(OpenVINO)或纯 CPU 硬件;执行对应后端的安装命令;做一次冒烟测试确认技能可加载;最后确定启动命令并写入注册表。失败时会读取错误输出并尝试自行修复,社区贡献的技能无需专门的安装脚本。
YOLO26 模型
YOLO26(2026 年 1 月)取消了 NMS 与 DFL,导出更干净、延迟更低:
| 模型 | 参数量 | 优化后延迟 | 适用场景 |
|---|---|---|---|
yolo26n (nano) |
2.6M | ~2ms | 边缘设备,CPU 实时 |
yolo26s (small) |
11.2M | ~5ms | 速度与精度均衡 |
yolo26m (medium) |
25.4M | ~12ms | 偏重精度 |
yolo26l (large) |
52.3M | ~25ms | 最高检测质量 |
所有模型均可检测 80+ COCO 类别:人、车辆、动物和日常物品。
安装与使用
推荐的使用路径是通过 SharpAI Aegis 桌面应用运行 DeepCamera 的 AI 技能:
- 几秒内接入 RTSP/ONVIF 摄像头、USB 摄像头,或直接用 iPhone 摄像头做测试
- 内置本地 LLM 与 VLM,自带 llama-server,无需额外配置
- 从技能目录一键部署技能,AI 辅助排错
- 一键从 HuggingFace 下载并运行 Qwen、DeepSeek、SmolVLM、LLaVA、MiniCPM-V
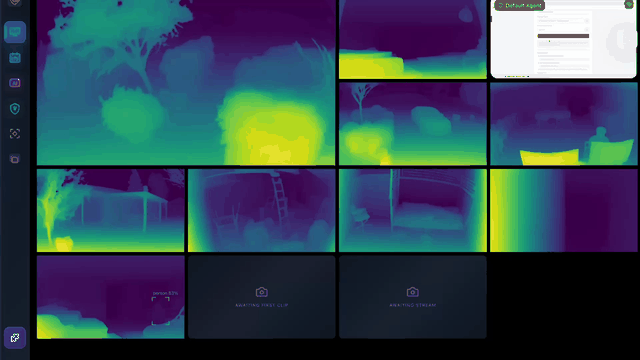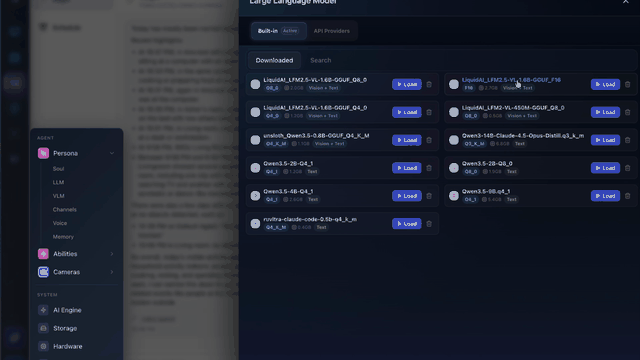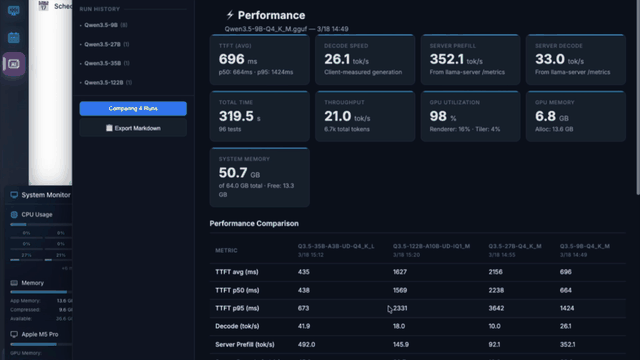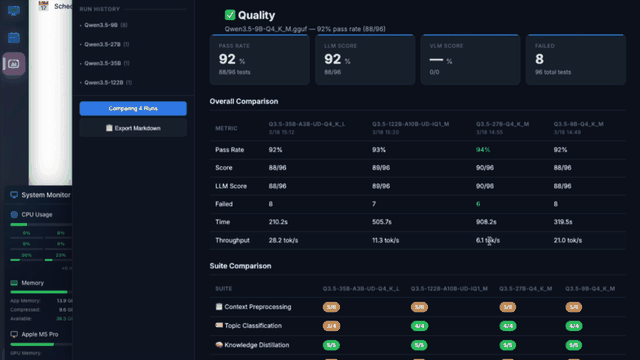
- 用 HomeSec-Bench 在自己的硬件上基准测试模型,找出最适合本机的 VLM
- 通过 Telegram、Discord 或 Slack 与你的“守卫”对话:询问发生了什么、告诉它要盯什么、获得带画面依据的 AI 推理回答
想自己开发技能,可参考 Skill Development Guide 与 Platform Parameters。
注意事项
- 项目采用 MIT 许可证。
- 技能目录中部分能力仍处于测试中或计划中状态,请以技能表中的 ✅ / 🧪 / 📐 标记为准。
- 推理全部在本地完成,实际可用模型与速度取决于本机硬件(NVIDIA、AMD、Apple Silicon、Intel 或纯 CPU)。
- YOLO26 模型延迟为优化后的参考值,不同设备上会有差异。
本作品整理自 GitHub 开源项目 SharpAI/DeepCamera,原作者 @SharpAI,许可证 MIT。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- v2026.3当前版本
136 次提交,将 DeepCamera 重构为去中心化 Skill Platform:18 个技能覆盖 10 大类别,采用标准 SKILL.md 清单与 JSONL 协议;新增 131 项测试的 HomeSec-Bench 基准套件并兼容 Qwen3.5。
评论