详细介绍
项目简介
SwiftLM 是一个用原生 Swift 编写的 MLX 模型推理服务器,对外提供严格 OpenAI 兼容 API。它不需要 Python 运行时,没有 GIL,也避免了不必要的内存拷贝,直接编译成单个二进制文件,发挥 Apple Silicon 的裸金属性能。项目同时提供命令行服务端(SwiftLM)和图形界面桌面应用(SwiftBuddy),仓库中还展示了 iOS 端的 SwiftBuddy 演示。
主要功能
- OpenAI 兼容 API:可直接作为本地推理后端接入现有客户端。
- 纯 Swift 单二进制:无 Python 依赖,构建完成后直接运行。
- MoE 模型 SSD 流式加载:使用
--stream-experts让超大的 MoE 模型绕过 macOS 虚拟内存交换,直接从 NVMe SSD 流式读取专家层,从而在有限内存上运行大模型。 - KV cache 压缩:提供
--turbo-kv等选项(仅适用于KVCacheSimple)。 - 推测解码:支持
--mtp配合 assistant 模型进行草稿解码。 - GUI 版本 SwiftBuddy:在 macOS 上点击「Model Options」即可选择或下载 MLX 本地模型开始对话。
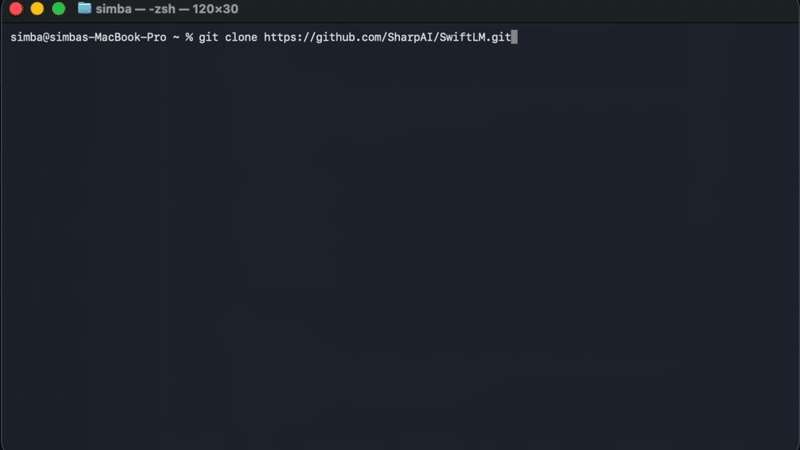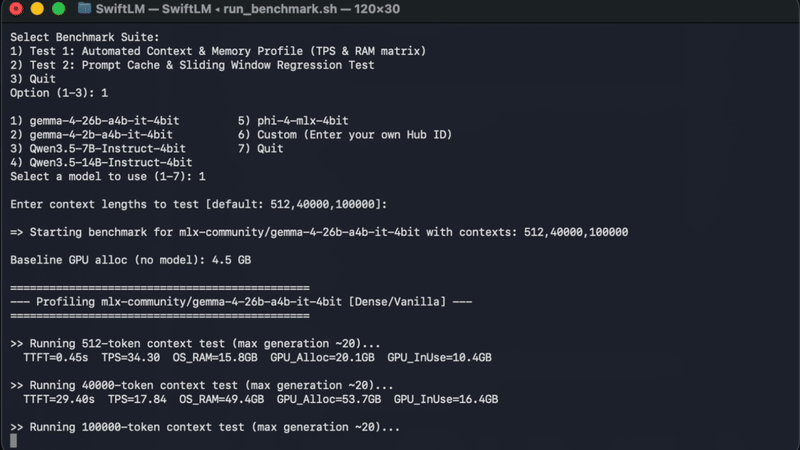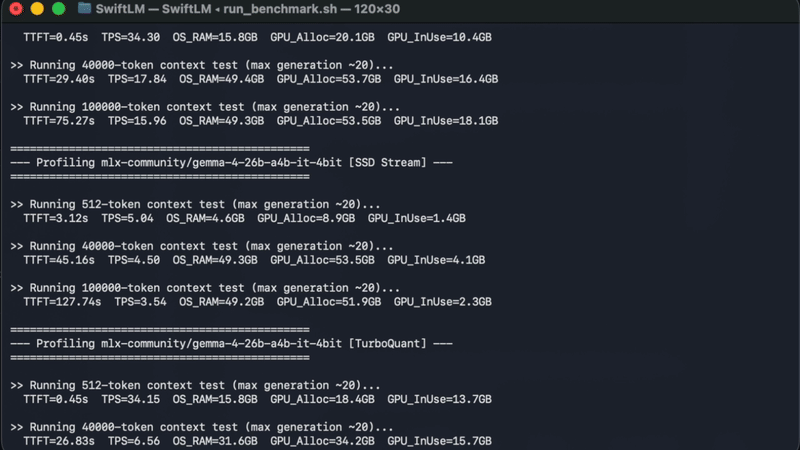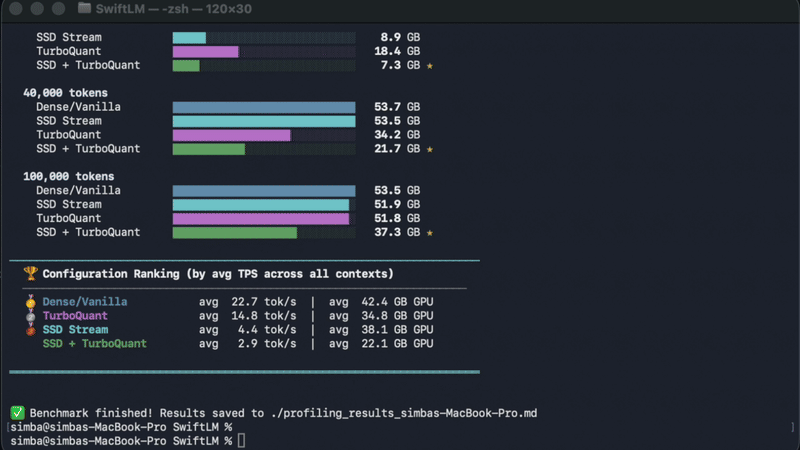
官方在 Mac mini M6(基础款,32 GB 统一内存)上给出了一组参考数据:gemma-4-26b-a4b-it-4bit(MoE,约 4B 激活参数)在 GPU 模式下短提示词解码约 53.9 tok/s;Qwen3.6-35B-A3B-UD-MLX-4bit 约 48.4 tok/s,改用 --stream-experts 后显存占用降到约 6.8 GB,解码约 13–14 tok/s。
安装与使用
方式一:下载预编译二进制(推荐)
从 Releases 页面下载 tarball,解压后直接启动。压缩包是自包含的,mlx.metallib 已随包提供。
tar -xzf SwiftLM-<version>-macos-arm64.tar.gz
./SwiftLM --model mlx-community/Qwen2.5-3B-Instruct-4bit --port 5413
方式二:从源码构建
构建脚本会自动处理 submodule、cmake、Metal kernel 编译和 Swift 构建。
git clone --recursive https://github.com/SharpAI/SwiftLM
cd SwiftLM
./build.sh
然后启动服务(模型未缓存时会自动下载):
.build/release/SwiftLM \
  --model mlx-community/gemma-4-26b-a4b-it-4bit \
  --port 5413
运行超大 MoE 模型时加上 --stream-experts,通过 SSD 流式加载专家层。
GUI 用户(SwiftBuddy):下载 release 中附带的 DMG,打开后把 SwiftBuddy.app 拖入「应用程序」,启动后点击「Model Options」选择或下载 MLX 本地模型即可对话。
运行测试:
make test
注意事项
- 仅面向 Apple Silicon(arm64)macOS,示例构建与性能数据均来自 macOS / Mac mini M6 环境。
mlx.metallib必须与SwiftLM二进制放在同一目录,缺失时 Metal GPU 计算会失败。- 测试请使用
make test,不要在全新 checkout 上直接跑swift test:MLX 加载不到 Metal 库时会中止进程,而swift test仍可能以 0 退出,导致看起来通过实际却几乎没执行。make test会在执行测试少于 200 个时判定失败。 - 在显存较小的机器(如 32 GB)上,8bit 大模型需要配合 SSD 流式加载,可支持的上下文长度会明显缩短。
- 使用
--mtp时,输出与不开启时可能在 temperature 0 下仍有差异。
本作品整理自 GitHub 开源项目 SharpAI/SwiftLM,原作者 @SharpAI,许可证 MIT。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- vb895当前版本
SwiftLM b895
- vb893
版本 b893 修复提示词缓存的保存时机:改为在对话轮次边界保存 prompt cache,使提前退出的请求也能保留缓存。
- vb886
更新 mlx-swift 子模块至 d5839e5。
评论