详细介绍
项目简介
SwarmLLM 是一款免费开源的桌面应用,让你在自己的电脑上运行 ChatGPT 风格的 AI 助手,所用模型来自 Meta、Google、Alibaba、Mistral 等厂商的开源模型。当某个模型大到一台机器放不下时,运行 SwarmLLM 的电脑可以通过互联网组队,各自负责模型的一部分,共同把它跑起来。
没有账号、没有订阅、没有广告、没有加密货币,开源且会自动更新。据 README 说明,2026 年 10 月 Llama 3.3 70B 曾在泰国、澳大利亚和意大利的四台普通电脑上完成回答,速度约为每秒一个词;项目的目标是让超大模型既快又对所有人免费。
主要功能
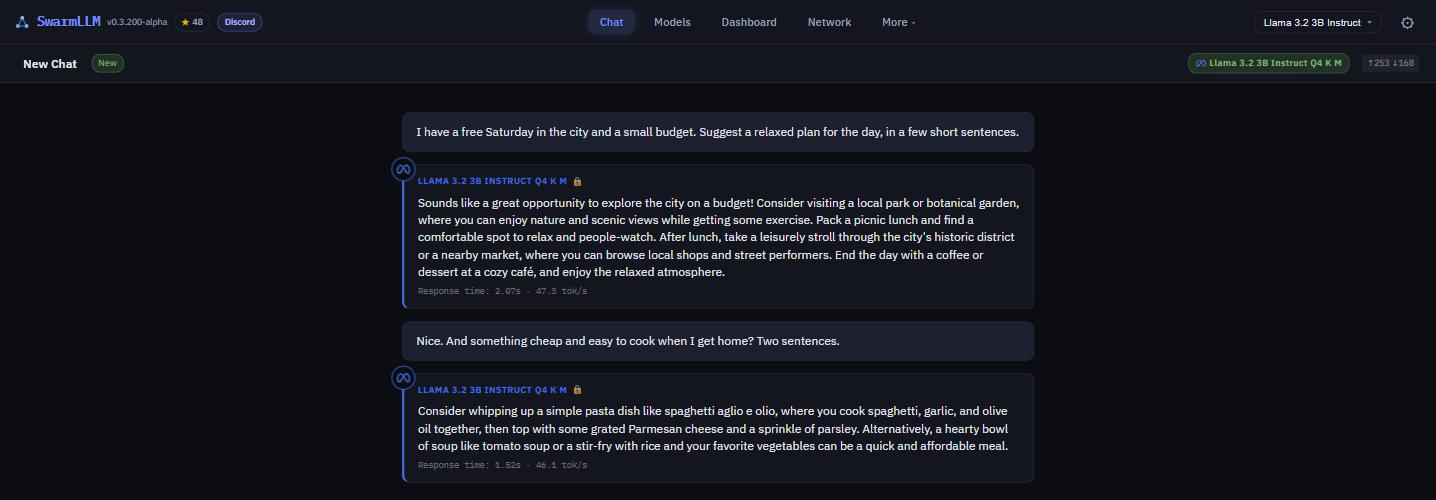
- 在本机聊天:模型下载一次后就在你自己的机器上运行,对面没有一家公司在接收你的对话。
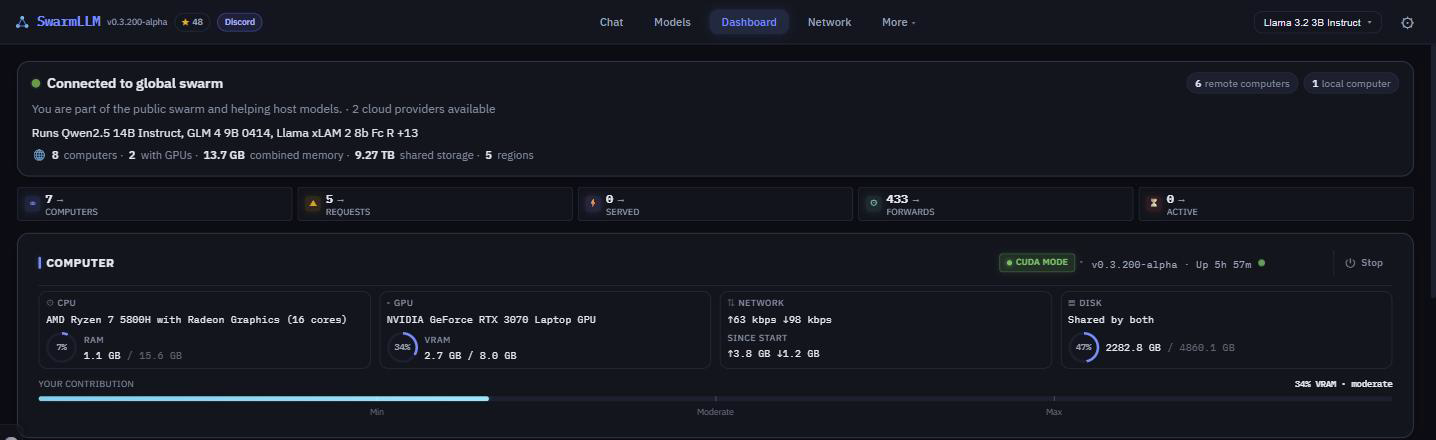
- 使用单机放不下的模型:组队中的电脑各持有一部分模型,轮流处理你的问题;彼此越近速度越快,例如你自己的笔记本与台式机,或同一地区的用户。
- 空闲时帮助他人:SwarmLLM 打开期间,你的电脑会保留热门模型的部分内容并帮别人回答问题,类似 BT 做种;没有付费,也没有代币,回报是整个群体能跑的模型你都能用。
- 连接自己的设备:把笔记本、台式机和家用服务器放进一个私有组,当作一台更大的机器使用。
- 接入现有应用:兼容 OpenAI 与 Anthropic API 的聊天应用、编程助手和 AI Agent 可以改用 SwarmLLM。
- 界面支持 21 种语言,可在手机上使用,并会显示每个回答由哪个模型生成、耗时多少。
安装与使用
从 latest release 页面 下载对应系统的压缩包。
Windows:有 NVIDIA 显卡(多数游戏 PC)下载 swarmllm-windows-x86_64-gpu.zip,AMD/Intel 显卡、无独显或不确定时下载 swarmllm-windows-x86_64-cpu.zip。解压后双击 swarmllm.exe;若出现「Windows protected your PC」提示,点击 More info 再点 Run anyway。随后弹出的黑色命令行窗口就是程序本体,请保持开启(可最小化),应用会自动在浏览器中打开;若没有自动打开,访问 localhost:8800。
Mac(M1 及更新的 Apple 芯片):下载 swarmllm-macos-aarch64.tar.gz 并解压,把文件夹放在 Documents 或 Downloads(不要放 Applications,否则无法自动更新),双击 swarmllm。首次启动会被系统拦截,需到「系统设置 → 隐私与安全性」点击 Open Anyway 后再次双击。Intel 芯片的 Mac 暂不支持。
Linux:使用 NVIDIA RTX 30 系列及以上显卡时下载 swarmllm-linux-x86_64-cuda.tar.gz,否则下载 swarmllm-linux-x86_64.tar.gz,解压后运行:
./swarmllm run
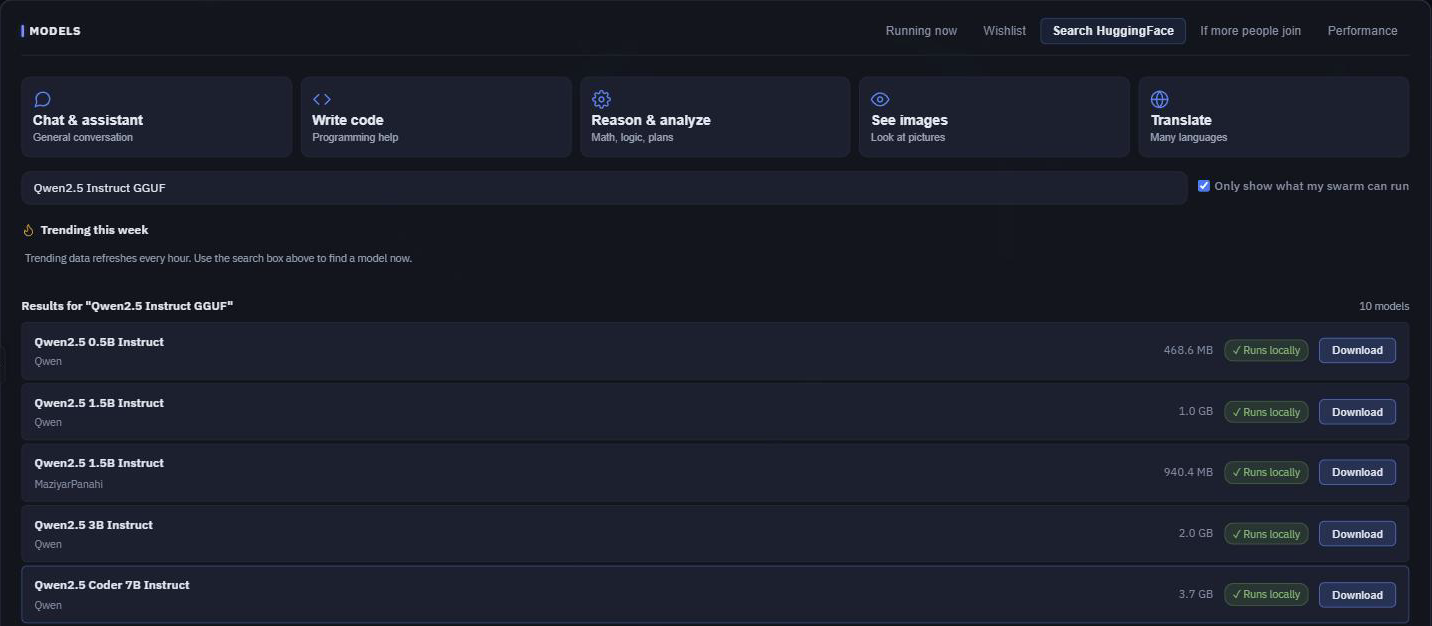
程序启动后,在 Models 标签中挑选适合本机的模型并下载(首次约几个 GB),即可开始聊天。
注意事项
- 项目仍处于早期版本,每周都在改进,修复会自动推送到你的电脑。
- 关闭终端或黑色命令行窗口即等于关闭 SwarmLLM。
- 跨洲组队已经可以运行 70B 模型,但速度很慢;同一地区的在线电脑越多,大模型越快。
- 处理器早于 2013 年的机器如果启动即报 Illegal instruction,请下载文件名以
-baseline结尾的版本。 - Docker 镜像、
.deb/.rpm包以及各系统的详细安装说明见官方 installation guide。
本作品整理自 GitHub 开源项目 enapt/SwarmLLM,原作者 @enapt,许可证 Apache-2.0。中文介绍由 AI 根据项目 README 整理,以原仓库为准。
更新记录
- v0.3.266-alpha当前版本
修复已保存 prompt 的内存占用量计算,避免为新腾出的空间误清其他会话的已保存 prompt;启动节点读取模型描述文件改为后台进行,消除了每次启动约 200-400 毫秒的网络消息阻塞。
- v0.3.265-alpha
修复长对话中显卡显存池持续增长、最终耗尽显存的问题,新增 SWARMLLM_CUDA_POOL_MARGIN 开关;被移到处理器的模型在显卡有余量后 2 分钟内自动迁回。
- v0.3.264-alpha
修复 70B 请求在一台机器持有全部层却放不下时被剔除导致失败的问题,重试会给该节点分配更少的层;同时把「本机开始并结束」模式下陆续返回的结果合并为一次读取,提升生成速度。
评论